はじめに
【Pythonによる時系列分析】で学んだ内容をダミーデータで再現してみた記事です。書籍のサンプルデータとは異なる特性を待たせています。
この記事では、営業訪問と受注の変化から「解約しそうな取引先」を決定木で予測します。データは乱数で作ったダミーで、実在のものではありません。
データ
600社分を用意し、次の変数を持たせました。「訪問が減った」または「受注が減り、かつ訪問が少ない」取引先が解約しやすいというルールを仕込んでいます。
visits/visits_diff: 月の営業訪問回数と前月差order_qty/order_qty_diff: 受注額と前月差churn: 解約したかどうか(解約率は約35%)
ステップ1: 制限なしの決定木は過学習する
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=123, stratify=y
)
full = DecisionTreeClassifier(random_state=123).fit(X_train, y_train)学習データの正解率は1.000、テストデータは0.778でした(木の深さは14)。学習データで満点でも、新しいデータでは外れることがわかります。
ステップ2: GridSearchCVで最適な木を探す
params = {
    "max_depth": range(1, 8),
    "criterion": ["gini", "entropy", "log_loss"],
    "min_samples_leaf": [1, 3, 5, 10, 20],
    "min_samples_split": [2, 5, 10, 20],   # 2以上にする
}
gs = GridSearchCV(DecisionTreeClassifier(random_state=123),
                  params, cv=5, scoring="f1", n_jobs=-1)
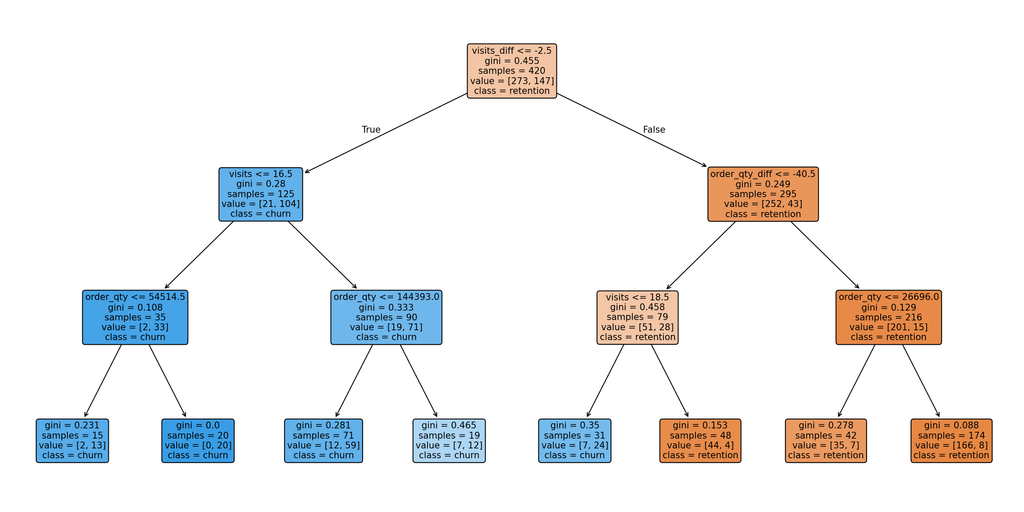
gs.fit(X_train, y_train)最適な組み合わせは、深さ3、min_samples_leaf=10 でした。Paramsの数が多いとめっちゃ時間がかかるのでまずはシンプルにやってみても良さそう。
ステップ3: テストデータで評価する
| 予測: 継続 | 予測: 解約 | |
|---|---|---|
| 実際: 継続 | 104 | 13 |
| 実際: 解約 | 6 | 57 |
正解率は0.89で、解約の再現率(recall)は0.90、適合率(precision)は0.81でした。
ステップ4: 決定木を読む
重要度は visits_diff(訪問回数の減少)が約73%で最も高く、次いで visits が17%でした。木の最初の分岐は「訪問が前月から2.5回超減ったか」です。仕込んだルールが、ほぼ再現されています。
ここで注意したい2つのこと
① 評価は必ずテストデータで。 全データで再学習して全データでスコアを見ると、学習データの数字になり、実力を測れません。
② 「予測できる」と「原因である」は別。 訪問の減少が解約の予測に効くからといって、訪問を増やせば解約が減るとは限りません。「解約しそうな相手を訪問しなくなった」という逆向きの関係かもしれないからです。施策の効果を確かめるには、因果推論(A/Bテストや差の差分法など)が必要です。
実務での使いどころ
- 解約リスクが高い取引先のリストを作り、営業やCSのフォロー順を決める
- 見逃しを減らしたいなら、再現率を重視して判定のしきい値を調整する
まとめ
決定木は、条件で分けたグループの中でさらに別の条件を設けることで、単純な集計では見えない傾向を見つけられます。探索的な分析で「どこを見るべきか」を絞る手がかりになりそうです。ただし結果は仮説なので、別のデータでの確認が必要です。
参考: 【Pythonによる時系列分析】
*本記事はプロモーションが含まれています
